C asi todo el mundo intenta montar su asistente personal por el mismo sitio: activando la memoria y contándole cosas. Funciona unas semanas. Luego llega el día en que le preguntas por el presupuesto que cerrasteis en marzo y te contesta algo plausible, redondo y equivocado — y a partir de ahí ya no sabes qué de lo que te dice es recuerdo y qué es relleno.
El problema no es el modelo: es haber puesto la información importante en el único sitio del sistema que no está diseñado para guardarla. Esta guía va en el orden contrario al de los tutoriales: primero qué recuerdan de verdad estos asistentes, después dónde tienen que vivir tus notas y tus tareas, y solo entonces cómo se conectan las piezas. Da por hecho que ya tienes claro por qué una IA «olvida» lo que le dijiste antes; si lo que buscas es decidir qué asistente usar, lo que toca es la comparativa de asistentes para no programadores, no esta.
Un asistente personal son cuatro piezas, y la IA es solo una
Cuando alguien dice «me he montado un asistente», casi siempre está describiendo la combinación de cuatro cosas distintas. Separarlas sirve para algo muy concreto: cuando el asistente falla, sabes cuál de las cuatro ha fallado.
1. Un almacén de notas que es tu fuente de la verdad
Archivos de texto en una carpeta, Obsidian, Notion, Apple Notes, lo que ya uses. La única condición que importa: que el dato siga ahí y siga siendo exacto aunque desactives la IA mañana.
2. Un almacén de tareas con estado
Una tarea tiene algo que una nota no tiene: está hecha o no lo está, y tiene fecha. Eso necesita un sitio que lo sepa — Todoist, Things, un tablero, una columna en una hoja de cálculo. Pedirle a un modelo que lleve la cuenta de tus pendientes «de cabeza» es exactamente el error que esta guía intenta evitar.
3. Una conexión que permita leer y escribir en los dos
Un conector, un MCP, una integración, una carpeta compartida. Aquí es donde se decide casi toda la seguridad del montaje, y lo vemos más abajo.
4. Una instrucción fija que no vuelvas a escribir cada vez
Las instrucciones de proyecto, el system prompt, el campo de «personalización». Es donde se escribe cómo quieres que trabaje: qué formato, qué tono, qué no debe hacer nunca, y sobre todo dónde tiene que mirar antes de contestar.
La memoria del modelo, la función que todo el mundo activa primero, no está en esta lista. Está a propósito: no es ninguna de las cuatro piezas, es una capa cómoda que se apoya encima. Y conviene saber qué es antes de confiarle algo.
La memoria de un asistente es un resumen, no un archivo
Esto no es una interpretación nuestra: es cómo lo describen las propias empresas. Anthropic habla literalmente de un «resumen de memoria» que Claude genera a partir de tus conversaciones y que puedes consultar y modificar desde los ajustes; y si trabajas con proyectos, crea una memoria separada para cada proyecto, de modo que lo que hablas en uno no se filtra al otro. En la actualización que anunció en agosto de 2026 añadió poder ver ese contenido tema por tema y editarlo o borrarlo pieza a pieza.
ChatGPT lo reparte en dos capas que vale la pena distinguir, porque se comportan distinto. Los recuerdos guardados son datos concretos — «soy vegetariano», «trabajo en zona horaria de Madrid» — que puedes abrir, editar y borrar de uno en uno. La referencia al historial de chats es otra cosa: no es una lista que puedas abrir, sino una capa que trabaja de fondo leyendo tus conversaciones anteriores, y lo que saca de ahí puede cambiar con el tiempo en lugar de quedarse fijo. La diferencia que importa es de control: los recuerdos guardados se auditan uno a uno; del historial solo puedes activarlo o desactivarlo. De ahí viene la sensación contradictoria de que unas veces se acuerda de un detalle que no le pediste guardar y otras afirma con la misma seguridad algo que nunca dijiste.
La regla práctica: la memoria es buena recordando cómo trabajas y mala recordando qué pasó. Preferencias, tono, formato, en qué estás metido: perfecto. Cifras, fechas, nombres de cliente, números de factura, decisiones con consecuencias: eso va a un archivo, y el asistente lo lee de ahí cada vez. Si el dato tiene que seguir siendo exacto dentro de seis meses, no vive en la memoria del modelo.
Hay un segundo motivo, menos obvio, para no apoyarse en la memoria: no sabes cuánto de ella entra en cada respuesta. Todo lo que el modelo tiene en cuenta compite por el mismo espacio limitado, y cuando ese espacio se llena lo que se pierde se pierde en silencio — el mecanismo está explicado en ventana de contexto y memoria. Un archivo que el asistente consulta cuando toca no tiene ese problema: o lo ha leído, o no lo ha leído, y eso se puede comprobar.
Las notas y las tareas las pones tú, y en formato que sobreviva
La decisión más importante de todo el montaje se toma antes de tocar nada de IA: en qué formato guardas lo tuyo. El criterio no es cuál es más bonito, es cuál sigue siendo legible si mañana cambias de asistente, de empresa o de opinión.
Texto plano o Markdown en una carpeta que controlas es la opción más aburrida y la que mejor envejece: lo lee cualquier modelo, cualquier editor y cualquier script, y no depende de que una empresa mantenga una función. Las herramientas con base de datos propia — Notion, Todoist, un tablero — aportan estructura y estado real a cambio de depender de su conector; es un intercambio razonable para tareas, donde el estado importa más que la portabilidad. Lo que no recomendamos a nadie es que la única copia de algo viva dentro del historial de un chat.
Una nota por tema, con el título diciendo de qué va
Un asistente que busca entre tus notas se guía por los títulos antes que por el contenido. «Cliente Martínez — condiciones 2026» se encuentra; «notas3» no. Es el cambio de hábito que más mejora los resultados y el que menos cuesta.
Los datos que no deben inventarse, en una lista y no en prosa
Precios, plazos, direcciones, condiciones. En una lista o una tabla corta, con una línea por dato. Un modelo parafrasea prosa con mucha facilidad; una lista de pares «campo: valor» la copia tal cual mucho más a menudo.
Una sola nota de «estado actual»
Un archivo corto, que actualizas tú o el asistente, con en qué andas ahora y qué está decidido. Es lo que convierte un asistente que responde preguntas en uno que retoma el hilo, y es mucho más fiable que esperar que lo deduzca de la memoria.
Cómo se enchufa: conectores y MCP
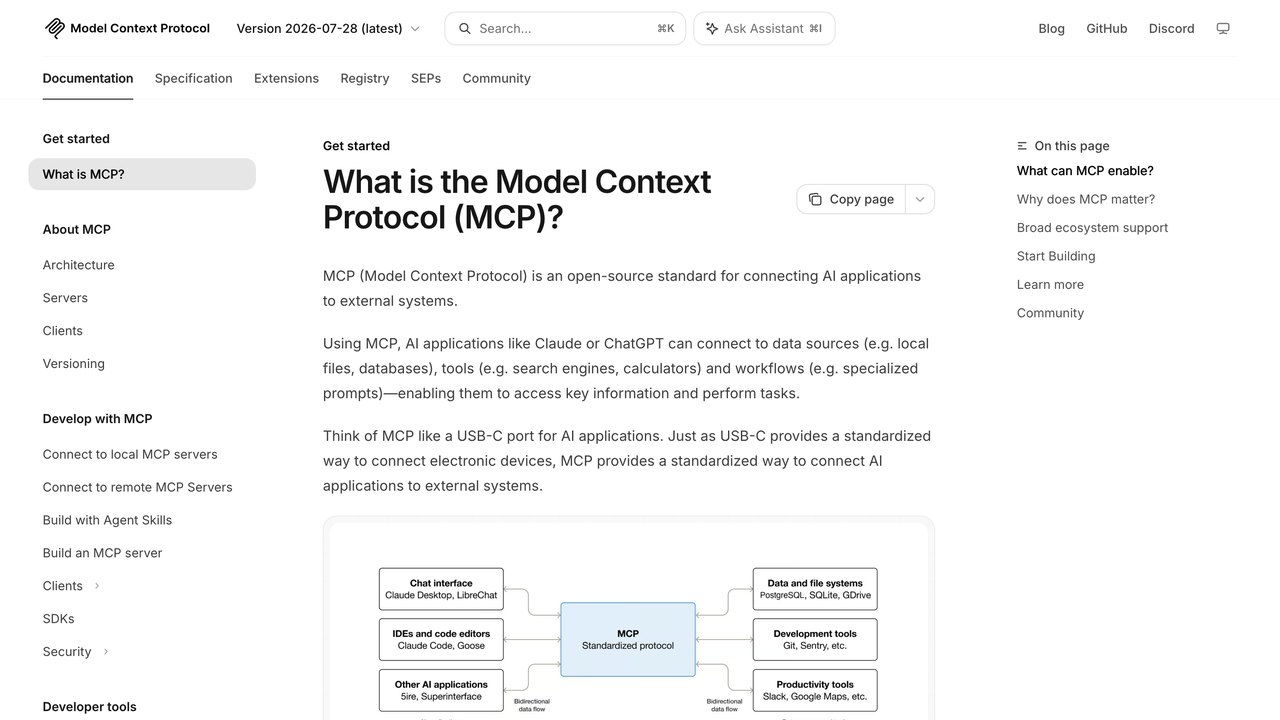
Para que el asistente lea y escriba en esos almacenes hace falta una conexión. Hoy hay un estándar que se ha impuesto para esto: MCP (Model Context Protocol), un protocolo abierto para conectar aplicaciones de IA con sistemas externos — archivos locales, bases de datos, buscadores, tus propias herramientas. Su propia documentación lo compara con un puerto USB-C: una forma única de enchufar, en lugar de una integración distinta para cada programa.
Lo que lo hace relevante para un montaje personal no es la elegancia técnica, es que lo soportan a la vez Claude, ChatGPT, Visual Studio Code y Cursor, entre otros. Traducido: el conector que configures no se queda atado a la aplicación en la que empezaste, que es exactamente el riesgo de montar tu vida encima de la integración propietaria de un producto. Lo tenemos desarrollado en MCP explicado.
Para la mayoría de la gente esto no implica programar nada: muchas aplicaciones de notas y de tareas ya publican su conector y se activa desde los ajustes. Escribir uno propio solo hace falta cuando tu herramienta no lo tiene, o cuando quieres que algo se ejecute sin que tú abras la aplicación.
El permiso que conviene mirar dos veces: al conectar algo, fíjate en si estás dando lectura o lectura y escritura, y sobre todo en si el alcance es una carpeta concreta o todo. Empieza por lectura, y por una carpeta. Ampliar después cuesta un clic; descubrir que llevabas un mes con acceso total a todo es otra conversación.
Móntalo en este orden, no todo a la vez
El montaje que falla es el que empieza conectando seis herramientas el primer día. Cuando algo sale mal no hay forma de saber qué fue, y se abandona. Este orden tarda más en parecer impresionante y bastante menos en ser útil.
Fase 1 — Una instrucción fija y nada conectado
Crea un proyecto o espacio dedicado y escribe ahí cómo quieres que trabaje: qué haces, qué formato quieres, qué no debe hacer nunca, y la frase que más rendimiento da de todas — que cuando no tenga el dato lo diga en lugar de rellenarlo. Pega a mano las dos o tres notas de contexto. Una semana así enseña más sobre qué necesitas que cualquier tutorial.
Fase 2 — Conecta las notas, solo en lectura
Una carpeta, no todo el disco. A partir de aquí el asistente deja de depender de lo que recuerde y empieza a depender de lo que lee, que es el cambio que de verdad importa. Comprueba una cosa antes de seguir: pregúntale por un dato que esté solo en una nota concreta, y luego por uno que no esté en ninguna. Tiene que acertar el primero y reconocer que no tiene el segundo.
Fase 3 — Añade las tareas, ahora sí con escritura
Es el primer permiso de escritura, y por eso va tercero y no primero. Empieza por un único tipo de acción — crear una tarea — y revisa a mano lo que crea durante unos días. Lo que vas a descubrir no es que se equivoque mucho: es que crea tareas vagas, y que eso se arregla en la instrucción fija, no cambiando de herramienta.
Fase 4 — Solo entonces, correo o calendario
Va al final por un motivo que no es la dificultad: es la primera pieza que mete en el sistema texto escrito por desconocidos. Hasta aquí, todo lo que leía el asistente lo habías escrito tú. Para el correo concretamente, el planteamiento que recomendamos está en cómo usar IA para gestionar el correo: clasificar y resumir antes que redactar y enviar.
El riesgo real: tu asistente obedece lo que lee
Aquí está el motivo por el que la fase 4 va al final. Un modelo no distingue de forma fiable entre «esto es contenido que debo analizar» y «esto es una instrucción que debo cumplir». Si un correo, una página web o un PDF compartido contiene un texto dirigido al asistente, hay una probabilidad real de que lo trate como una orden tuya. Eso es prompt injection, y en un asistente personal tiene una forma muy concreta.
Lo que convierte el problema en algo serio no es ninguno de los permisos por separado, es la suma de tres: acceso a datos sensibles, capacidad de escribir o enviar, y salida a internet. Con los tres juntos en la misma sesión, alguien que no eres tú puede conseguir que el asistente lea algo tuyo y lo saque fuera, sin explotar ningún fallo de software — simplemente escribiendo el texto adecuado donde el asistente lo va a leer.
Cuatro medidas que sí cambian algo: no juntes los tres permisos en una misma sesión; deja lo irreversible — enviar, borrar, pagar, compartir — detrás de una confirmación tuya explícita; procesa el correo entrante en un espacio que no tenga acceso de escritura a tus notas; y revisa de vez en cuando qué guardó la memoria, porque una instrucción colada también puede acabar ahí y sobrevivir a la conversación.
Que esto no es teórico lo marca la propia industria: el 2 de octubre de 2026 Apple endureció el «acceso total al disco» en macOS señalando directamente el riesgo de los agentes de IA, mientras Google probaba un permiso de acceso total en su aplicación de escritorio — dos respuestas opuestas a la misma pregunta, contadas en esta noticia. Mientras los fabricantes no se pongan de acuerdo, el que decide cuánto ordenador le das a un asistente eres tú.
Qué sale de tu ordenador, y el modo incógnito mal entendido
Un asistente personal es, por definición, el sistema donde acumulas lo más tuyo. Merece la pena tener claras dos cosas antes de llenarlo.
La primera: salvo que uses un modelo en tu propia máquina, todo lo que el asistente lee pasa por un servidor ajeno, conector incluido. «Está en una carpeta local» no significa que se quede local si el que la lee es un modelo en la nube. Qué implica eso en la práctica, y qué conviene no pegar nunca, está en cómo proteger tus datos al conectar la IA; y si el contenido es lo bastante sensible como para que la respuesta sea «esto no sale de aquí», la opción es ejecutar la IA en tu propio ordenador, con la pérdida de capacidad que eso supone.
La segunda es un malentendido muy repetido. El modo incógnito evita que una conversación entre en la memoria y en el historial, y para eso funciona bien: es la herramienta correcta cuando no quieres que algo contamine lo que el asistente cree saber de ti. Pero la propia documentación de ayuda de Anthropic recoge un detalle que casi nunca se repite: esas conversaciones se conservan igualmente un mínimo de 30 días por motivos de seguridad y obligaciones legales, y en los planes de equipo entran además en las exportaciones de datos de la organización. No es un borrado, es una exclusión de la memoria. Para lo que de verdad no debe existir en un servidor ajeno, la decisión no es qué modo de chat eliges: es no escribirlo ahí.
Cuándo no merece la pena montártelo
Señales de que la respuesta honesta es «no», o «todavía no»:
- No tienes el sistema de notas antes de la IA. Un asistente conectado a notas desordenadas devuelve desorden más rápido. La IA no sustituye al hábito de escribir las cosas; lo amplifica, en el sentido que ya tuviera.
- Lo que quieres es que alguien decida por ti. Estos sistemas son buenos recuperando, resumiendo y redactando. En el momento en que la tarea es decidir con consecuencias, el asistente es un ayudante con el que piensas, no el que firma.
- Son datos de clientes o de terceros y no has mirado el encaje legal. Si por tu trabajo manejas datos personales ajenos, conectar eso a un asistente no es una decisión de productividad. Es una decisión con implicaciones de protección de datos que toca revisar antes, no después.
- Esperas que funcione sin mantenimiento. Los conectores cambian, las funciones se renombran, los permisos se amplían en una actualización. Un asistente personal es algo que se revisa cada pocos meses; si eso no te apetece, usa la versión simple de la fase 1 y quédate ahí — sigue siendo útil.
Y si después de esa lista sigue teniendo sentido, móntalo en el orden de arriba: la instrucción fija primero, los archivos como fuente de la verdad, la memoria como comodidad y no como almacén, y la escritura y el correo al final. Lo que se obtiene no es un mayordomo digital, que es lo que se vende. Es algo más modesto y bastante más útil: un sitio donde tu contexto está escrito una sola vez y no tienes que volver a explicarlo.