1. Instala Ollama (la vía más simple)
Ollama es una herramienta gratuita y de código abierto que convierte "instalar un modelo de IA" en un solo comando de terminal, sin configuración manual. Disponible para macOS, Windows y Linux.
# 1. Descarga Ollama desde ollama.com e instálalo (como cualquier programa normal)

# 2. Abre una terminal y descarga tu primer modelo
ollama pull llama3.2

# 3. Empieza a hablar con él, ya sin conexión a internet
ollama run llama3.2

# Para salir de la conversación
/bye
A partir de ahí, Ollama también expone una API local en tu propio ordenador (normalmente en localhost:11434) que puedes usar desde tus propios scripts o aplicaciones — el mismo patrón de API que usarías con un proveedor en la nube, solo que apuntando a tu máquina en vez de a un servidor externo.
2. Qué modelo elegir según tu RAM
El factor que más determina qué modelo puedes correr no es tu procesador, es la memoria RAM disponible. Un modelo de código abierto se mide en miles de millones de "parámetros" — cuantos más tiene, más capaz es, pero también más memoria necesita para cargarse.
| RAM disponible | Tamaño de modelo | Ejemplo |
|---|---|---|
| 8 GB | 3.000-4.000 M parámetros | llama3.2 (3B), phi3 |
| 16 GB | 7.000-8.000 M parámetros | llama3.1 (8B), mistral, gemma2 |
| 32 GB o más | 13.000-30.000 M parámetros | qwen2.5 (14B-32B), mixtral |
Referencia orientativa, no exacta — el consumo real también depende del nivel de "cuantización" (compresión) del modelo que descargues.
3. Qué es la "cuantización" y por qué decide si tu modelo cabe
Cada parámetro de un modelo es, en el fondo, un número. La cuantización reduce la precisión con la que se guarda cada uno de esos números — de 16 bits a 8, a 4, incluso menos — para que el modelo ocupe menos espacio en memoria y cargue más rápido, a cambio de perder algo de calidad en las respuestas. Ollama descarga por defecto una versión ya cuantizada de cada modelo (normalmente en 4 bits), pensada para funcionar bien en hardware de consumo sin que tengas que configurar nada.
Ocupa menos RAM, responde más rápido, pero pierde precisión en tareas que exigen matices — puede notarse en textos largos o instrucciones complejas.
Más fiel al modelo original, pero necesita más RAM y responde más despacio — solo compensa si tu hardware tiene margen de sobra.
Para empezar, la versión por defecto que descarga ollama pull es la elección correcta en la mayoría de casos — solo merece la pena tocar el nivel de cuantización si notas que la calidad se queda corta para tu uso, o si tienes RAM de sobra y quieres exprimir algo más de precisión.
4. Los modelos abiertos más usados, uno junto a otro
| Modelo | Quién lo hace | Se nota bien en |
|---|---|---|
| Llama | Meta | Uso general, el más probado por la comunidad |
| Mistral | Mistral AI (Francia) | Buen equilibrio velocidad/calidad en tamaños pequeños |
| Gemma | Eficiencia en poca RAM | |
| Qwen | Alibaba | Código y razonamiento, buena relación tamaño/capacidad |
| DeepSeek | DeepSeek | Razonamiento paso a paso en modelos de mayor tamaño |
No hay un "mejor" absoluto — todos mejoran con cada versión nueva, y la diferencia entre dos de tamaño similar suele notarse solo en tareas concretas. Si no sabes por dónde empezar, llama3.2 es la opción más segura por ser la más documentada y probada por la comunidad.
«IA local no es "una versión peor de ChatGPT". Es una herramienta distinta, para cuando lo que más te importa no es la capacidad máxima, sino que el dato no salga nunca de tu equipo.
— Redacción El Telar
5. LM Studio: la vía con interfaz gráfica
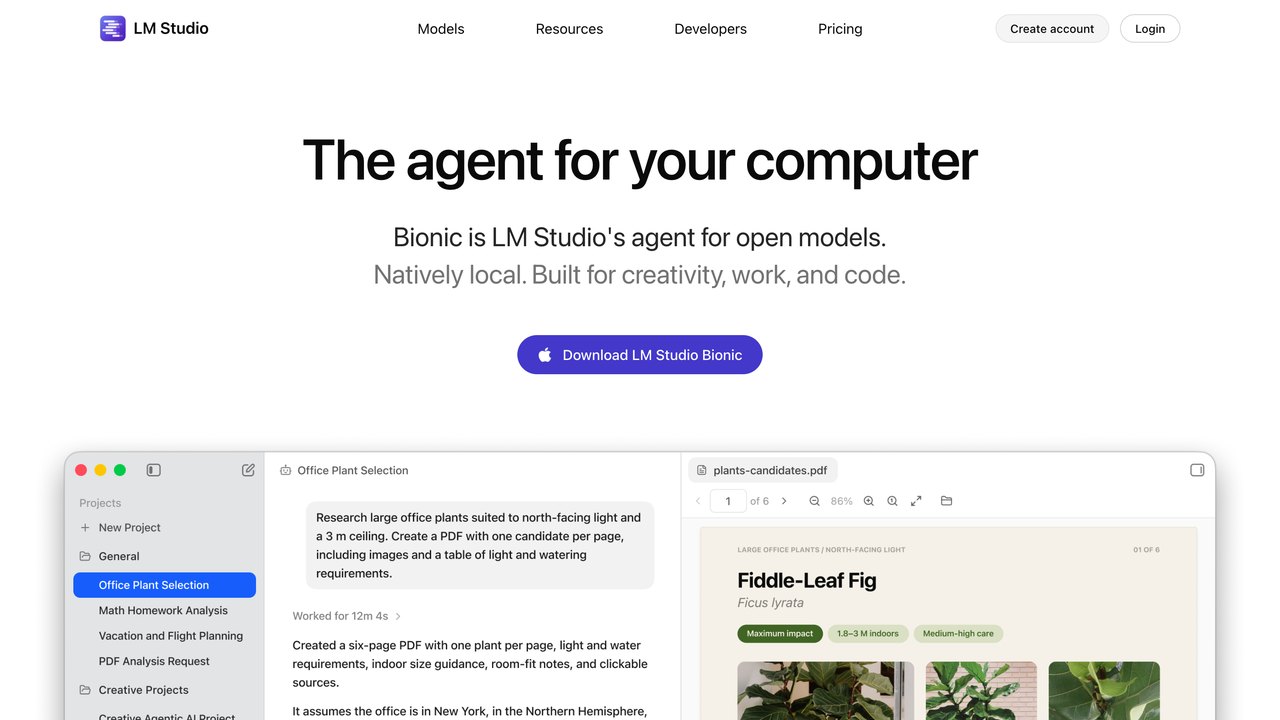
Si prefieres no tocar la terminal, LM Studio ofrece exactamente lo mismo que Ollama pero con una interfaz de ventanas: un buscador de modelos con indicadores visuales de qué tamaños encajan con tu hardware, un chat integrado, y un servidor local que puedes activar con un botón en vez de un comando. Es la opción más cómoda para quien viene del mundo de aplicaciones de escritorio normales y quiere evitar la línea de comandos por completo.
6. Para qué merece la pena de verdad
Contratos, historiales médicos, código propietario — cualquier cosa que no quieras que salga de tu red, sin depender de la política de privacidad de un tercero.
Si haces miles de consultas sencillas al mes (clasificar texto, resumir emails cortos), el coste cero por consulta compensa rápido frente a una API de pago.
Para depurar un fallo difícil o razonar sobre un problema con muchos pasos, un modelo frontera en la nube sigue rindiendo mejor por un margen real — no te frustres si el local se queda corto ahí.
Un modelo local no navega la web por defecto — si tu tarea depende de información muy reciente, necesitas conectarlo a herramientas externas, lo que añade complejidad y, de nuevo, conexión a internet.
7. Conectarlo a tus propios documentos, sin que salgan de tu equipo
Una vez tienes un modelo local funcionando, el siguiente paso natural es que responda preguntas sobre tus propios documentos — contratos, apuntes, informes — sin que ese contenido salga nunca de tu ordenador. La técnica se llama RAG (Retrieval-Augmented Generation) y consiste, en esencia, en indexar tus documentos en una base de datos local y hacer que el modelo consulte esa base antes de responder, en vez de depender solo de lo que aprendió durante su entrenamiento. Tanto LM Studio como varias herramientas complementarias de Ollama (AnythingLLM es la más sencilla de instalar) ofrecen esto con una interfaz de "arrastra tu carpeta de documentos" sin necesidad de programar nada. Si quieres entender cómo funciona por dentro antes de montarlo, nuestra guía de RAG explicado cubre el mecanismo completo, aplicable igual en la nube que en local.
8. La diferencia legal, no solo técnica, de que el dato no salga
Cuando envías un documento a un chat en la nube, ese contenido sale de tu equipo y pasa por los servidores de otra empresa, sujeto a su política de retención de datos — aunque no lo use para entrenar modelos, técnicamente ha "salido". Con un modelo local, ese problema desaparece por diseño: no hay ningún servidor externo al que enviar nada, porque todo el procesamiento ocurre en tu propia máquina. Para profesiones sujetas a secreto profesional (abogacía, medicina, asesoría fiscal) o para empresas con clientes que exigen contractualmente que sus datos no salgan de un perímetro concreto, esa diferencia no es un matiz técnico — puede ser la diferencia entre poder usar IA para un caso concreto o no poder usarla en absoluto.
9. Los problemas habituales y cómo resolverlos
Va muy lento, una palabra cada varios segundos
El modelo no cabe en la memoria rápida y el sistema está usando el disco. Prueba una versión más pequeña (menos parámetros) o más cuantizada, y cierra el navegador y otras aplicaciones pesadas mientras lo usas.
El ordenador se calienta y el ventilador no para
Es normal durante la generación: el procesador o la gráfica trabajan al máximo. En un portátil, úsalo enchufado y sobre una superficie dura.
Responde en inglés aunque le hable en español
Algunos modelos pequeños se entrenaron sobre todo en inglés. Pide explícitamente "responde siempre en español" o elige un modelo con buen soporte multilingüe.
Se inventa cosas con más facilidad que ChatGPT
Es esperable: un modelo que cabe en un portátil tiene mucha menos capacidad que los grandes modelos en la nube. Úsalo para tareas acotadas sobre texto que tú le das, no como enciclopedia.
No encuentra el modelo después de instalarlo
Comprueba el nombre exacto con el comando de listado de Ollama. Un error de una letra en la etiqueta del modelo es la causa más común.
10. Tres usos concretos donde lo local compensa
La pregunta útil no es si un modelo local es tan bueno como ChatGPT, porque no lo es. Es si para esta tarea basta, y si el hecho de que nada salga de tu equipo cambia algo.
Resumir documentos confidenciales
Actas de reuniones, informes internos o documentación de clientes. Un modelo mediano resume bien texto que tú le das, y no tienes que preguntarte qué condiciones de uso tiene un servicio externo.
Clasificar o etiquetar mucho texto
Cientos de correos, reseñas o tickets. En local no pagas por uso, así que puedes procesar grandes volúmenes sin vigilar la factura de una API.
Trabajar sin conexión
En un tren o en un sitio con mala cobertura, un modelo local sigue funcionando. Para redactar, reformular o traducir borradores es suficiente.
Resume el siguiente documento en:
1. Cinco puntos clave (máximo una línea cada uno).
2. Decisiones o acuerdos que aparecen.
3. Tareas pendientes con su responsable, si se menciona.

Usa solo la información del documento. Si algo no está claro, escribe "no se indica".

Documento:
[pega aquí el texto]
11. Actualizar modelos y recuperar espacio en disco
Cada modelo ocupa varios gigas, y es fácil acabar con una docena descargados después de probar. Tanto Ollama como LM Studio permiten ver la lista de modelos instalados y borrar los que no uses; conviene revisarla de vez en cuando. Los modelos abiertos también se actualizan: las nuevas versiones suelen mejorar sin necesitar más memoria, así que merece la pena mirar si hay una revisión reciente del que usas.
Un consejo práctico: quédate con dos modelos, uno pequeño y rápido para tareas sencillas y otro más grande para cuando necesites más calidad. Tener diez no te aporta nada y te llena el disco.
Colibri: modelos gigantes en un ordenador normal
Colibri es un programa de código abierto que mueve modelos de IA enormes, de cientos de miles de millones de parámetros, en un ordenador sin tarjeta gráfica. El truco: estos modelos (llamados de «mezcla de expertos») solo usan una parte pequeña de sí mismos para cada palabra, así que Colibri guarda esa parte en la memoria y lee el resto del disco cuando hace falta.
Hoy funciona con modelos como GLM, Kimi, DeepSeek V4 Flash y Qwen 3.6, y también tiene un motor para generar imágenes.
Dónde conseguirlo: JustVugg/colibri · repositorio oficial ↗
En Windows:
Descarga el ZIP desde «Code → Download ZIP» y abre START-HERE.bat
En Mac (con Homebrew):
xcode-select --install
brew install libomp git python
git clone https://github.com/JustVugg/colibri
cd colibri && ./start-here.sh
Es gratis (Apache 2.0). Pide como mínimo 8 GB de RAM (mejor 16) y unos 22 GB libres en el disco para el modelo más pequeño. Ojo con las expectativas: al leer del disco va bastante más lento que Ollama con un modelo que cabe entero en memoria, así que para el día a día sigue siendo mejor la opción de Ollama que explicamos arriba. Colibri tiene sentido cuando quieres probar un modelo grande que no te cabría de ninguna otra forma.