D urante años, usar un modelo de lenguaje significaba escribir. Ahora puedes soltarle la foto de una factura arrugada, la captura de un panel que no entiendes o un informe en PDF, y pedirle que razone sobre ello. Funciona, y a menudo mejor de lo que esperabas. El problema es que también falla, y falla de formas que no se parecen a los errores que ya conoces del texto: no te dice "no puedo leer esto", te da una cifra equivocada con la misma seguridad con la que te habría dado la correcta.
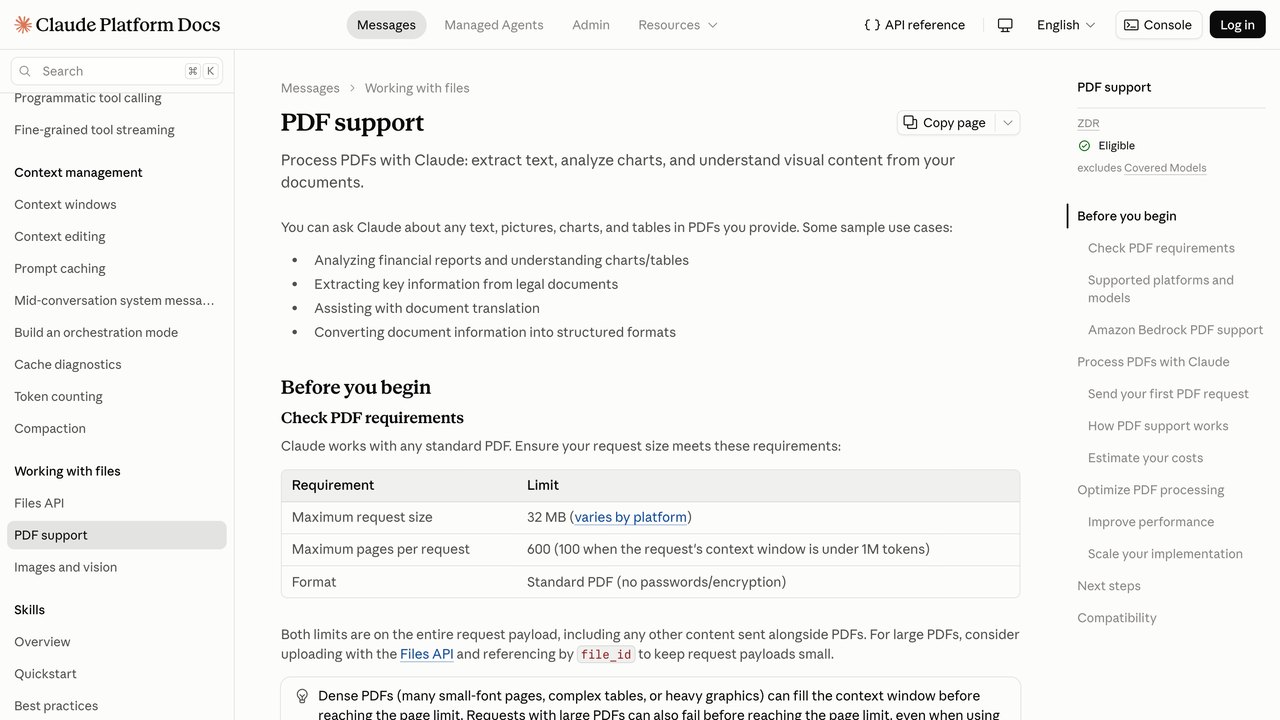
Esta guía no va de qué herramienta es "la mejor" para ver imágenes. Va de entender qué pasa entre que sueltas el archivo y recibes la respuesta, porque casi todos los fallos y casi toda la factura se explican ahí. Los límites concretos que aparecen abajo salen de la documentación oficial de Anthropic y de Google para sus respectivas APIs; son los que estaban publicados al escribir esto, y conviene que los compruebes el día que montes algo encima de ellos.
Tu PDF no se lee: se fotografía
La intuición natural es que el modelo "abre" el PDF y lee el texto, como harías tú. No es lo que ocurre. Anthropic lo documenta paso a paso para su API: el sistema convierte cada página del documento en una imagen, extrae además el texto de esa página, y le entrega al modelo las dos cosas a la vez. El modelo mira la foto de la página y lee la transcripción en paralelo.
Esa doble entrega no es un capricho: es lo que permite preguntar por un gráfico de barras, por la casilla marcada de un formulario o por la estructura de una tabla a dos columnas. Un extractor de texto clásico te habría devuelto las cifras del gráfico solo si estaban escritas como texto; la vía de la imagen le deja además ver la barra.
De aquí salen dos consecuencias prácticas que conviene tener claras antes de seguir. La primera: un PDF escaneado —una fotocopia, un fax antiguo, un contrato firmado y pasado por el escáner— no tiene capa de texto, así que solo recorre la vía de la imagen. Todo lo que el modelo sepa de ese documento sale de mirarlo, con los errores de lectura que eso implica. Si lo que vas a pasar por ahí es justamente un contrato, conviene saber antes qué parte de esa revisión puedes delegar y cuál no. La segunda es de dinero, y va en la sección siguiente.
La prueba de los treinta segundos: abre el PDF e intenta seleccionar un párrafo con el ratón. Si puedes seleccionarlo, tiene capa de texto. Si el cursor resbala por encima como si fuera una foto, es un escaneo — y ahí es donde se concentran casi todos los errores de lectura.
Los límites que sí están publicados
Estos son los techos documentados por cada fabricante. Importan porque son la diferencia entre que tu proceso funcione y que devuelva un error a mitad de un lote de mil documentos.
32 MB por petición, contando todo lo que mandes junto. Hasta 600 páginas por petición, que bajan a 100 si el modelo tiene una ventana de contexto menor de un millón de tokens. Cada imagen, hasta 10 MB y 8000×8000 px. En claude.ai, 20 imágenes por mensaje. Formatos: JPEG, PNG, GIF y WebP — las animaciones no se admiten, solo se usa el primer fotograma.
Hasta 50 MB o 1.000 páginas por documento. Google publica además una cifra útil para calcular: cada página de documento equivale a 258 tokens. Las páginas grandes se reescalan a un máximo de 3072×3072 px y las pequeñas se amplían hasta 768×768, conservando la proporción.
Con ChatGPT la cosa es menos clara, y conviene decirlo tal cual: OpenAI no publica un límite oficial de páginas por PDF. El techo real acaba siendo el presupuesto de tokens del archivo y de la conversación, no un número redondo que puedas consultar. Si estás decidiendo dónde montar un proceso serio de documentos, esa opacidad es en sí misma un dato: no puedes dimensionar contra una cifra que nadie publica.
Y una advertencia que vale para las tres: estos números se mueven. La tabla de arriba es la foto del momento en que se escribió esta guía. Si vas a construir algo encima, ábrete la documentación del fabricante el mismo día y compruébalo — es literalmente un minuto, y te ahorra descubrirlo en producción.
Por qué una captura de pantalla sale más cara de lo que crees
Aquí está la parte que sorprende a casi todo el mundo la primera vez que mira la factura. Anthropic documenta que su modelo no ve píxeles sueltos, sino parches de 28×28 px, y que cada parche es un token visual. La cuenta es directa: una imagen cuesta ⌈ancho / 28⌉ × ⌈alto / 28⌉ tokens visuales.
Una imagen de 1000×1000 px son 36×36 parches: 1.296 tokens visuales, según la propia tabla de la documentación. Es decir, una captura cuadrada modesta te cuesta aproximadamente lo mismo que unas mil palabras de texto. Y un PDF, recuerda, es una imagen por página más el texto extraído: Anthropic calcula entre 1.500 y 3.000 tokens por página según la densidad del contenido.
Hay un segundo factor. Los modelos recientes de Anthropic trabajan en una resolución mayor —hasta 2576 px de lado largo y 4.784 tokens visuales, frente a 1568 px y 1.568 tokens en los anteriores— y la documentación avisa de que eso puede multiplicar por tres el coste en tokens de la misma imagen. Más fidelidad para documentos densos, sí, pero se paga.
Lo que esto significa en la práctica: si mandas una captura en 4K, el sistema la va a reescalar de todas formas antes de procesarla. Redimensionarla tú antes de subirla no te quita calidad que fueras a aprovechar — te quita factura. Y si lo único que necesitas es el texto de un PDF que ya tiene capa de texto, extraerlo y pegarlo como texto plano es varias veces más barato que subir el PDF entero. Si quieres poner números a tu caso, tenemos una calculadora de coste de API.
Dónde falla, según quien lo fabrica
Lo más útil de la documentación de Anthropic sobre visión no son las capacidades: es la lista de limitaciones, que es inusualmente franca para un material de producto. Merece la pena repasarla entera porque cada punto corresponde a un error real que te vas a encontrar.
Imágenes pequeñas, giradas o de mala calidad
La documentación admite que el modelo puede alucinar o equivocarse interpretando imágenes de baja calidad, rotadas o muy pequeñas —menciona explícitamente por debajo de 200 píxeles—. Es exactamente el perfil de una foto de un recibo hecha con el móvil de lado y con poca luz.
Contar cosas
Da conteos aproximados, y el error crece cuando hay muchos objetos pequeños. Si tu tarea es "cuántas unidades hay en esta estantería" o "cuántas filas tiene esta tabla", no delegues la cifra sin comprobarla.
Posiciones y coordenadas
Las salidas de localización son aproximadas, y la propia documentación pide verificarlas antes de depender de ellas. Relevante si pretendes recortar automáticamente una región concreta de un documento.
Detectar si una imagen es generada por IA
No puede, y la documentación lo dice sin rodeos: pide que no se use para eso. Si alguien te vende un detector de imágenes falsas que por dentro es un modelo generalista al que se le pregunta "¿esto es real?", te está vendiendo humo.
No lee los metadatos
El modelo no recibe ni analiza los metadatos de la imagen. La fecha, el modelo de cámara o las coordenadas GPS del EXIF no le llegan: si necesitas ese dato, extráelo tú con otra herramienta y pásaselo como texto.
Imágenes médicas y personas
Anthropic señala que el modelo no está diseñado para interpretar pruebas diagnósticas complejas como un TAC o una resonancia, y que sus salidas no sustituyen a un profesional. Tampoco identifica a personas en imágenes: se niega por política de uso.
A esa lista conviene añadir un hallazgo que se repite en las evaluaciones de documentos publicadas este año, y que es quizá la frase más útil de toda esta guía si piensas automatizar algo: el acierto medio sobre PDFs limpios no predice el rendimiento sobre documentos escaneados, manuscritos o de maquetación variable. Traducido: la demo con el informe corporativo bien maquetado no te dice nada sobre cómo se va a comportar con las facturas reales de tus proveedores. La única prueba que vale es con tus documentos peores, no con los mejores.
La letra manuscrita sigue siendo el caso más duro de todos. Ha mejorado mucho, pero es donde más separación hay entre modelos y donde más caro sale confiarse. Si tu flujo depende de leer anotaciones a mano, mide el acierto sobre una muestra tuya antes de montar nada encima.
Cómo pedirlo para que salga bien
Buena parte de los errores evitables se corrigen con cambios que no cuestan nada. Estos salen de las buenas prácticas que publica Anthropic y de lo que se nota al usarlo a diario.
1. El archivo primero, la pregunta después
Igual que con los documentos largos de texto, el modelo rinde mejor cuando la imagen o el PDF van antes de tu pregunta. Funciona al revés, pero peor. Es el cambio más barato de la lista.
2. Endereza las páginas
Orientación vertical correcta, siempre. Una página girada 90 grados es una de las causas documentadas de error, y rotarla antes de enviarla es cuestión de un clic.
3. Redimensiona tú, no dejes que lo haga el sistema
Si la imagen supera el máximo del modelo, se reescala sola — y al reescalarse, el texto pequeño puede volverse ilegible. Mejor que decidas tú el recorte y el tamaño, sabiendo qué parte importa.
4. Cuidado con comprimir de más
Un JPEG muy comprimido pesa menos y viaja más rápido, pero los artefactos de compresión afectan al rendimiento, y con texto pequeño lo destrozan. La documentación recomienda mirar de verdad la imagen que estás enviando, no la original.
5. No recortes el contexto por agrandar el texto
Es un error frecuente: ampliar tanto una cifra que se pierde la cabecera de la columna a la que pertenece. El número se lee mejor y significa menos.
6. Pide la cita antes que la conclusión
"Transcribe literalmente la línea donde aparece el total, y solo después dime cuál es" da mejores resultados que preguntar directamente por el total. Obligarle a copiar antes de interpretar deja el error a la vista, que es justo la lógica del grounding aplicada a documentos.
7. Numera las páginas como las ve el visor
Al referirte a una página concreta, usa el número que muestra el visor de PDF. Y si envías varias imágenes sueltas, etiquétalas ("Imagen 1:", "Imagen 2:") para poder referirte a ellas después sin ambigüedad.
Una nota aparte sobre los documentos que subes. Un PDF de trabajo suele llevar nombres, cuentas, direcciones o datos de clientes, y al subirlo sales de tu ordenador. Antes de convertirlo en rutina, revisa qué política de retención tiene la herramienta concreta que usas y si el plan que tienes contratado entrena con lo que envías; lo desarrollamos en la guía sobre cómo proteger tus datos al usar IA.
Cuándo no deberías usar un modelo generalista
Hay una idea instalada de que los modelos grandes han dejado obsoleto al OCR de toda la vida. Los resultados publicados este año en las comparativas de documentos dicen algo más matizado: modelos de OCR especializados y comparativamente diminutos —del orden de mil millones de parámetros— rinden mejor que modelos multimodales generalistas cientos de veces más grandes en las pruebas centradas en documentos.
No es una contradicción, son dos trabajos distintos. Un modelo generalista es para entender y razonar sobre un documento: qué dice este contrato, qué implica este gráfico, en qué se diferencian estas dos versiones. Un OCR especializado es para transcribir a escala: convertir diez mil facturas escaneadas en datos estructurados, con un coste por documento y una tasa de error que puedes medir y presupuestar.
La regla práctica: si el volumen es alto y la pregunta siempre es la misma, monta una tubería especializada y usa el modelo grande solo para los casos que esa tubería marque como dudosos. Si el volumen es bajo y la pregunta cambia cada vez, el modelo generalista es justo lo que quieres. Pagar tokens visuales por transcribir en masa algo que un OCR hace mejor y más barato es el error caro de este año.
Cómo decidirlo en una tarde: coge veinte documentos reales tuyos, y que sean los peores que tengas — escaneos torcidos, fotocopias, anotaciones a mano. Pásalos por las dos vías. Cuenta los errores a mano, uno a uno. Veinte documentos bien contados te dan una respuesta más fiable que cualquier comparativa publicada, porque están medidos sobre tus documentos y no sobre los de otro.
Preguntas frecuentes
En resumen
La entrada multimodal ha dejado de ser una demo y ya resuelve trabajo real, pero se comporta como una herramienta con mecánica propia, no como magia. Merece la pena quedarse con tres cosas: tu PDF llega al modelo como imágenes más texto, y eso explica a la vez lo que puede ver y lo que te cobra; las limitaciones que importan están publicadas por los propios fabricantes, así que leerlas sale más barato que descubrirlas; y la única evaluación que sirve es la que haces con tus peores documentos, no con los que enseñaría un comercial.
Si vas a automatizar algo con esto, el orden sensato es: mide primero sobre una muestra real tuya, pon una comprobación que detecte el error antes de que llegue a producción, y sube la autonomía solo cuando los números aguanten. Es la misma cautela que aplicamos a cualquier agente — y aquí, donde el error viene disfrazado de cifra concreta y bien formateada, con más razón.
Queda una entrada que esta guía no cubre y que funciona con una lógica distinta: el sonido. Transcribir, sintetizar voz o clonar la de alguien tiene sus propios fallos —una transcripción puede inventarse una frase entera sin que se note— y, a diferencia de leer un PDF, arrastra obligaciones legales propias. Está en la guía de clonar voz, transcribir y generar audio con IA.